跳转至

快速开始

1. 安装

pip install rapidocr onnxruntime

2. 使用

rapidocr -img "https://www.modelscope.cn/models/RapidAI/RapidOCR/resolve/master/resources/test_files/ch_en_num.jpg" --vis_res
from rapidocr import RapidOCR

engine = RapidOCR()
img_url = "https://www.modelscope.cn/models/RapidAI/RapidOCR/resolve/master/resources/test_files/ch_en_num.jpg"
result = engine(img_url)

print(result.txts)
print(result.scores)
result.vis("vis_result.jpg")

Note

result.vis() 会在首次运行时自动下载可视化所需字体。离线环境可以省略这一行,或提前配置 font_path。

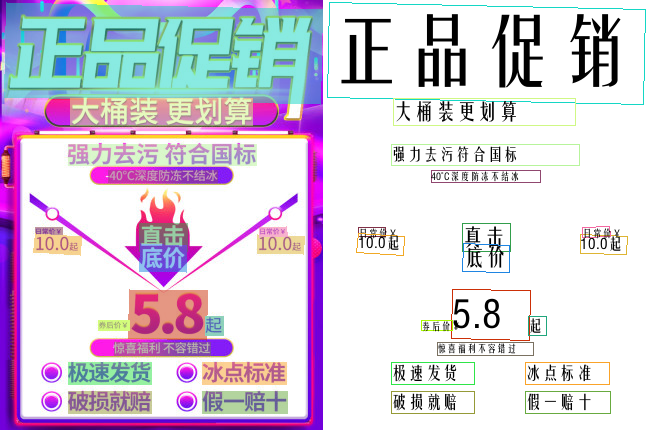
3. 查看可视化结果

4. 查看 result 结果

result 是一个 RapidOCROutput 数据类。最常用的字段如下:

字段 类型 含义
boxes np.ndarray 每行文本的四点坐标,形状为 (N, 4, 2)
txts Tuple[str] 识别出的文本,顺序与 boxes 一致
scores Tuple[float] 每行文本的置信度
elapse float 整体推理耗时,单位为秒
print(result.boxes.shape)
print(result.txts)
print(result.scores)

完整的输出结构和检测、分类、识别三阶段结果,请参见 使用教程。

推荐阅读

其他编程语言支持

评论